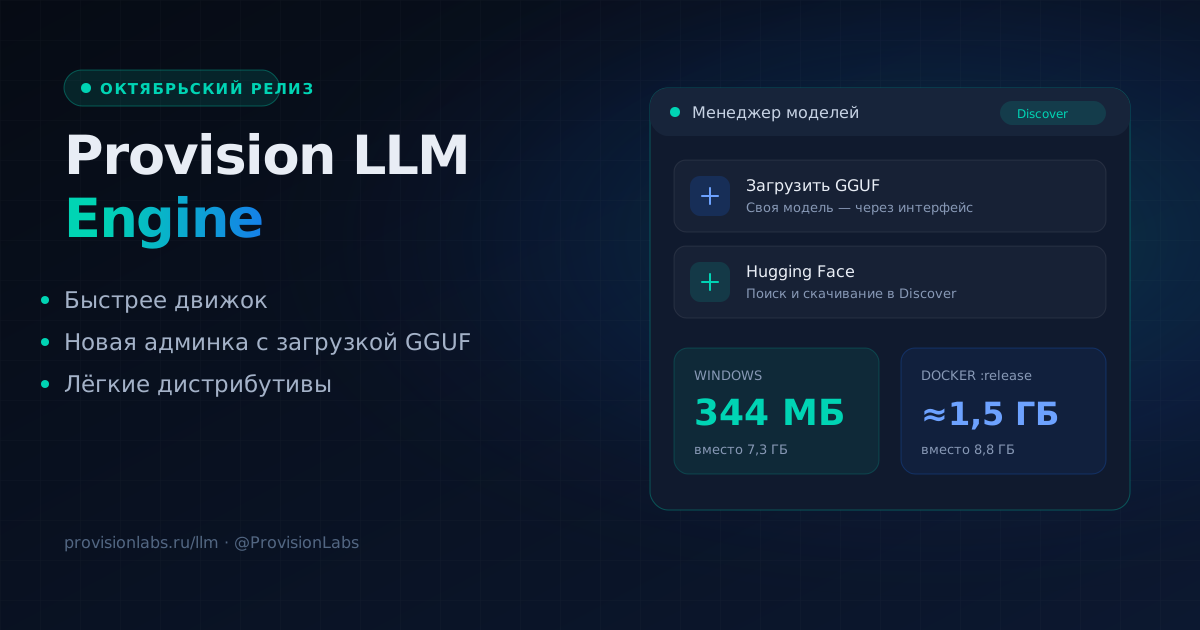
Мы выпустили октябрьское обновление Provision LLM Engine. В нём ускорен движок инференса, появилась удобная админ-панель для работы с моделями, а дистрибутивы стали заметно легче. Рассказываем, что изменилось с 8 по 29 октября 2026 года и что учесть при обновлении.
Быстрее движок: от выбора токена до работы с GPU
В этом релизе мы оптимизировали несколько участков, которые непосредственно влияют на скорость обработки запросов:
- Низкобитные кванты на CUDA. Ускорен MMVQ, а Stream-K в MMQ теперь ограничивается реальным объёмом работы.
- MoE-модели. Добавлен GPU-кэш для экспертов, которые хранятся в памяти хоста; на Pascal для MoE всегда используется MMVQ.
- Детерминированная генерация. При температуре 0 токен выбирается жадно, без прохождения полной цепочки сэмплеров.
- Шаблоны и спецтокены. Ускорены копирование контекста Jinja и экранирование спецтокенов без
std::regex. - AMD и Intel. В Vulkan-версии есть оптимизации для AMD, а также исправления инициализации устройств и обходы для Intel Arc на Windows.
Практический эффект зависит от модели, квантования, видеокарты и сценария генерации, поэтому мы не приводим один усреднённый процент для всех конфигураций.
Новая админка: модели загружаются через интерфейс
Windows-версия получила админ-панель, а в WebUI появились менеджер моделей и вкладка Discover. Теперь не обязательно вручную искать файлы и править конфигурацию для каждой модели.
- Загружайте собственные GGUF-модели через интерфейс.
- Находите и скачивайте модели с Hugging Face.
- Управляйте загруженными и недокачанными моделями в одном месте.
- Работайте через корпоративный прокси: HTTP-клиент учитывает
HTTP_PROXYиHTTPS_PROXY.
В Windows админ-панель доступна на 127.0.0.1:8080. Ключ доступа создаётся при первом запуске, а ярлыки для панели, ключа, папки моделей и models.ini добавляются в меню «Пуск».
Лёгкие дистрибутивы без встроенных моделей
Мы убрали веса моделей из установщика и Docker-образов. Дистрибутив больше не содержит гигабайты данных, которые могут не понадобиться конкретному пользователю: нужные модели можно скачать или загрузить после установки.
| Дистрибутив | Раньше | Теперь |
|---|---|---|
| Windows Setup.exe | 7,3 ГБ | 344 МБ |
Docker :release | 8,8 ГБ | около 1,5 ГБ |
Windows-установщик теперь состоит из одного файла и содержит необходимый Visual C++ runtime, поэтому отдельная установка Redistributable не требуется. Если файла модели из preset нет, сервер пропускает её с предупреждением в логе и продолжает запуск.
Единое и понятное хранилище моделей
В Docker все модели, добавленные во время работы, попадают в /models-rw: скачанные с Hugging Face — в hf, загруженные и скопированные вручную — в local. Подключите этот каталог как том, чтобы сохранить модели при пересоздании контейнера или обновлении образа.
В Windows модели, настройки, ключ админки и состояние лицензии хранятся в C:\ProgramData\ProvisionLLM. Эти данные переживают обновление и удаление программы, а модели из прежней папки установки переносятся при обновлении.
Стабильнее под нагрузкой
Отдельное внимание мы уделили корректной работе движка и повторному использованию контекста:
- улучшено распределение запросов по слотам и сохранение их состояний;
- в кэш промптов попадают только состояния, которые можно восстановить;
- исправлены инвалидация SWA-чекпойнтов и порог повторного использования SWA;
- устранены гонки в CUDA flash attention и выходы за границы памяти в MMQ;
- исправлены ошибки памяти и инициализации в Vulkan.
Также обновлена работа лицензий: новая офлайн-лицензия подхватывается без ручной очистки счётчика, а ошибка записи на диск больше не маскируется под исчерпание лимита.
Для обучения и малого бизнеса
Новый релиз упрощает первый запуск локального ИИ: меньше скачивать при установке, проще добавить подходящую модель, удобнее экспериментировать с разными GGUF. Это полезно для учебных занятий, прототипов и небольших рабочих процессов.
Provision LLM Engine можно использовать для локальных ИИ-ассистентов, поиска по документам и интеграций внутри собственного контура — без передачи рабочих данных во внешнее облако. OpenAI- и Anthropic-совместимые API, embeddings, reranking, LoRA, MCP и router-режим остаются доступны для интеграций.
Что учесть при обновлении
- Если вы использовали модели, встроенные в прежний Docker-образ
:release, добавьте их через админку или смонтируйте файлы в/models. - Проверьте том
MODELS_RW_DIR, чтобы скачанные модели сохранялись при пересоздании контейнера. - При ручном запуске
provision-serverбез--portпорт по умолчанию теперь 9931; штатные лаунчеры задают порт явно. - Уже израсходованные Trial-запросы при обновлении не сбрасываются.
Скачайте и пользуйтесь Trial-версией бесплатно
Попробуйте новый релиз в своём окружении: скачать Provision LLM Engine. Подробности установки и работы с моделями — в документации на GitHub.
Бесплатный Trial — до 1000 запросов, без перезапуска сервера.
🧠 Provision LLM Engine · 💬 Следите за обновлениями в Telegram: @ProvisionLabs