Мы упорно работаем над тем, чтобы наши продукты были лучшими на рынке, — и выпускаем новую версию OCR-системы. Provision OCR 0.9.3 научилась читать рукописный текст, распознавать документы на заданном языке, обрабатывать PDF постранично и выравнивать «кривые» сканы. Ниже — что это даёт на практике и что поменялось в API.
✍️ Рукописный текст на русском
Анкеты, заявления, накладные с подписями и пометками от руки — то, на чём классический OCR обычно сдаётся. В 0.9.3 появился отдельный режим распознавания рукописного русского текста: слова находятся по маскам, а читает их специально обученная рукописная модель.
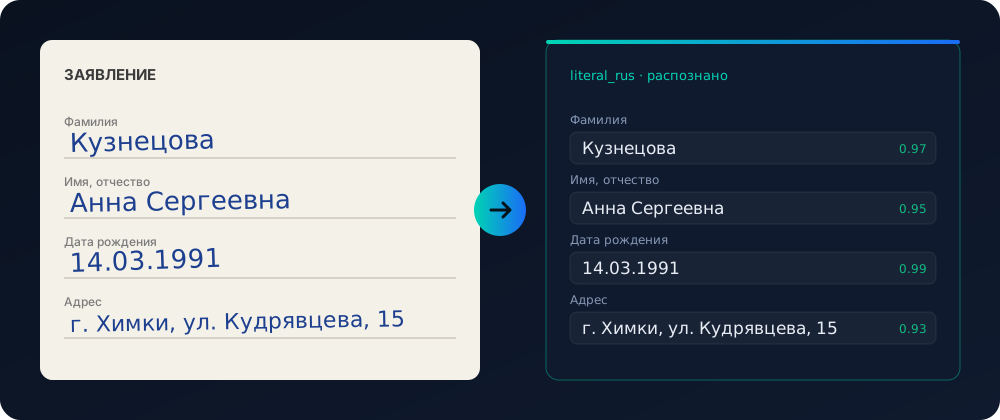
Режим включается параметром language=literal_rus. Извлечение таблиц в нём отключено — рукописный режим сосредоточен на тексте.
🌍 Многоязычность: язык распознавания под ваш документ
По умолчанию OCR сам разбирается, где кириллица, а где латиница. Но если язык документа известен заранее, его теперь можно указать явно — и получить максимальную точность без лишних «угадываний»:
rus— всё читается русским распознавателемeng— латиница: в ответе только цифры, знаки и ASCII-буквы, символ вне набора заменяется наиболее вероятным допустимым (café → cafe)rus,engили без параметра — оба алфавита с автоматическим роутером, как раньшеliteral_rus— рукописный русский
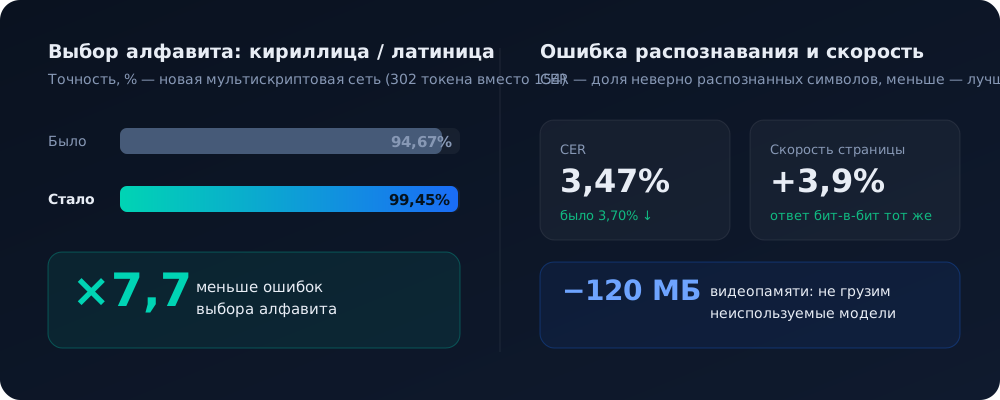
Сам автоматический выбор алфавита тоже стал заметно точнее: его перевели на новую мультискриптовую сеть.
📑 Постраничная обработка PDF
Большие документы и многостраничные договоры теперь можно обрабатывать окнами страниц — без ограничений по объёму и без лишней нагрузки. Укажите диапазон в запросе, а в ответе сервер сообщит реальное число страниц документа, чтобы клиент мог листать PDF без пробного запроса. Номера страниц в ответе остаются исходными — перенумерации нет.
📐 Наклонные и «кривые» сканы
Документ, сфотографированный на телефон под углом, больше не проблема. Сервер определяет остаточный наклон страницы и выравнивает её перед распознаванием. Работает это аккуратно: наклон меньше 4° не трогается, а угол применяется только тогда, когда его подтверждают строки текста на странице.
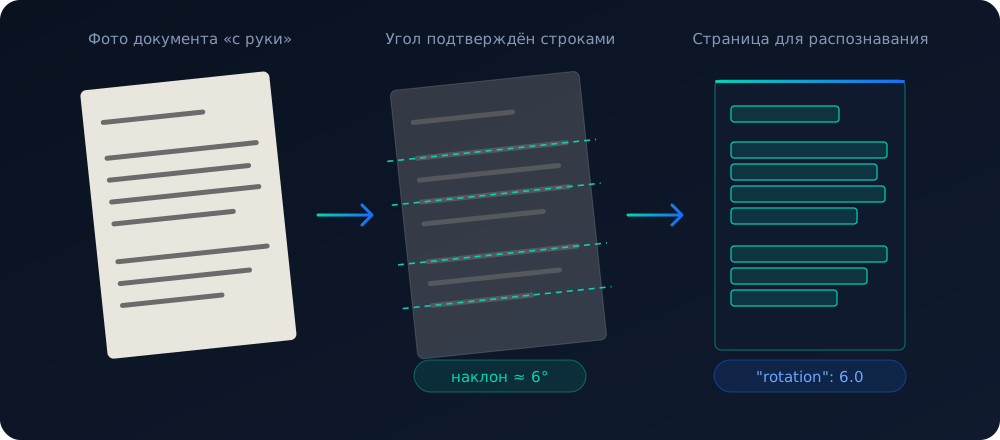
Угол, на который сервер повернул страницу, возвращается в поле rotation — по нему удобно контролировать качество входящих сканов.
Изменения в API
Все изменения обратно совместимы: ни один эндпоинт и ни одно поле не удалены, новые параметры необязательны. Существующие интеграции продолжат работать без правок.
Новые параметры POST /processing/{template}
| Параметр | Назначение |
|---|---|
language | Выбор распознавателя: rus, eng, literal_rus, можно через запятую. По умолчанию — rus,eng с автоматическим выбором алфавита. Неизвестное значение — ответ 400. |
pagesFrom | Только PDF: первая страница диапазона, с нуля, включительно. По умолчанию 0. |
pagesTo | Только PDF: конец диапазона, не включительно (pagesFrom=0&pagesTo=3 — первые три страницы). По умолчанию — до последней страницы. |
curl -X POST "http://localhost:8098/processing/agreement?pagesFrom=0&pagesTo=10" \
     -F "file=@contract.pdf"

curl -X POST "http://localhost:8098/processing/default?language=literal_rus" \
     --data-binary @form.jpg
Новые поля в ответе
documents[].pagesFrom,pagesTo,maxPages— для PDF: запрошенный диапазон и реальное число страниц документаpages[].rotation— угол по часовой стрелке, на который сервер повернул страницу перед распознаванием (например,-7.43). Поля нет, если сервер страницу не анализировал — это не то же самое, что 0. Координатыlocостаются в исходной системе координат страницыblocks[].det_prob— уверенность детектора в самой рамке слова. Дополняетprob: высокийprobпри низкомdet_probозначает уверенно прочитанный, но сомнительный фрагмент
{
  "documents": [{
    "pagesFrom": 0, "pagesTo": 10, "maxPages": 37,
    "pages": [{
      "page_number": 1,
      "rotation": -7.43,
      "blocks": [{ "text": "Договор", "prob": 0.99, "det_prob": 0.94 }]
    }]
  }]
}
Сервисные эндпоинты
POST /license/activate— новый: онлайн-активация лицензии по коду без перезапуска сервера. Доступна даже на заблокированном сервере, повторный вызов с тем же кодом не расходует новый слотPOST /health— теперь возвращает иversionзапущенной сборки, например{"status": "ok", "version": "0.9.3"}POST /reload_service— перечитываетprovision_ocr.iniи позволяет переключать модели без перезапуска процесса. Конфигурация проверяется целиком до применения (ошибка — ответ 400, рабочие настройки не трогаются), второй параллельный вызов получает 409
Под капотом: полный список изменений
Добавлено
- Автоматическое выравнивание остаточного наклона страницы — включено по умолчанию, наклон менее 4° не трогается, угол применяется только при подтверждении строками текста
- Поле
rotationу страницы в ответе API - «Второе мнение» при распознавании: слово ниже порога уверенности перечитывается распознавателем другого алфавита, выбирается более уверенный результат
Улучшено
- Выбор алфавита (кириллица/латиница) переведён на новую мультискриптовую сеть — 302 токена вместо 154: точность выросла с 94,67% до 99,45%, ошибок выбора в 7,7 раза меньше, CER снижен с 3,70% до 3,47%
- Скорость обработки страницы выросла на 3,9% при бит-в-бит идентичном ответе: ускорена постобработка детектора текста, добавлен кэш тепловых карт, не загружаются неиспользуемые модели — минус ~120 МБ видеопамяти
- В Windows-инсталлятор входят 18 моделей (fp16, ~1,06 ГБ) и 9 списков классов — ровно то, что сервер запрашивает при старте
Исправлено
- Текст больше не пропадает из ответа при вырожденной сетке таблицы
- Пунктирные линейки теперь распознаются как разделители таблицы — раньше таблица склеивалась в одну строку или столбец
- Устранены фантомные столбцы в таблицах
- Толстая или наклонная линейка больше не даёт две строки вместо одной по краю таблицы
- Половина таблицы больше не принимается за внешнюю рамку с потерей второй половины
Удалено
- Из инсталляционного бандла убраны две модели, которые больше не используются
Поддерживаемые видеокарты и дистрибутивы
| Видеокарта | Windows | Docker |
|---|---|---|
| NVIDIA RTX 40xx (Ada Lovelace) | 2,3 ГБ | 8 ГБ |
| NVIDIA RTX 30xx (Ampere) | 2,3 ГБ | 8 ГБ |
| NVIDIA RTX 20xx (Turing) | 2,3 ГБ | 8 ГБ |
| NVIDIA 10xx (Pascal) | 2,3 ГБ | 8 ГБ |
| AMD Radeon RX 6xxx (RDNA 2) | 2,3 ГБ | 8 ГБ |
docker pull registry.provlabs.tech/hub/provision_ocr:latestУстановщик для Windows и инструкции — на странице загрузки, подробности API — в документации.
И это не всё
Параллельно готовим релиз Provision LLM Engine — значительно вырастет скорость на современных видеокартах.
👉 Provision OCR · 🧠 Provision LLM Engine · 💬 Следите за обновлениями в Telegram: @ProvisionLabs